[20110223]
‧DTW path onset selection 一個midi frame對多個wav frame的問題
1. midi的ADSR之A第一個值不從零開始,改成0.1。(也許是因為0對noise太敏感)
2. midi onset frame定為A state的中間。
‧MATLAB記憶體不足的問題
1. use memory defragmentation (因為MATLAB需要連續的記憶體)
2. frequency domain用其他的scale
3. others...
‧目前的Cakewalk舊版讀MAPS的midi會有錯
[20110217]
W partial之外的bin設為0的方法。請和2/9的圖來比較。

[20110210]
schedule:
deterministic harmonic constraint -> temperal smoothnese -> spectral smoothnese
[20110209]
同樣是 Friedrich Gulda 的 K 281 - Andante Amoroso
抓了一個低音域的連續八度音片段


但是實際上它的能量真的很小,且看的出來三倍頻能量比基頻大許多。

後來去看西班牙鋼琴資料庫的一些低於100Hz左右的單音頻譜,
發現也有某些二三倍頻的能量大於基頻許多的例子。
[20110126]
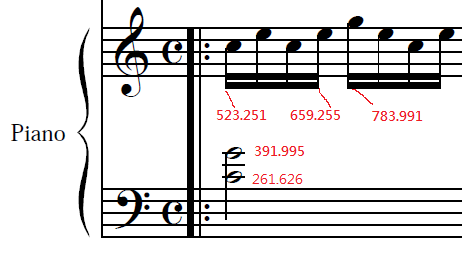
All is 440Hz.
piano : wav


[20110125]
P mask, tone model, if else.
[20110120]
Midi note envelope:

Otherwise, S and R can be scaled.
K281.Andante - 2 bar
1. 將第1、2個template除外的其他template (3rd~13th),給之inital H,
而W的部分先用原本gaussion的initial partial方式來training ,如下圖。

結果:


兩者好像差不多...
[20110119]
harmonic bands寬度: 一個半音->半個半音
Mean of all onset difference (Midi synthesized-G Air-2 bars)
0 garbage = 0.057472555 -> 0.057610769
1 garbage = 0.167695353 -> 0.087274952 (!)
對付實際演奏的音檔,應該還是需要garbage template的存在,
所以以後把bandwidth設成半個半音來做實驗好了。
因此將garbage template 個數1,半個半音的bandwidth為參數,
改變midi envelope為ADSR,如下圖:

Mean of all onset difference : 0.087274952 -> 0.400023036
結果每個onset都變糟了!
以template #14: 440Hz為例,共有三個note,

左圖是簡單的梯形envelope,Diff = ( 0, 0.053333333, 0.022358277 )
右圖是新的ADSR envelope,Diff = ( 0, 0.152018141, 0.376462585 )
看圖,如果把onset的位置像老師說的定在A stage的中間,那麼應該會準一點吧!
[20110118]
Friedrich Gulda - Mozart Piano Sonata K 281 - 2. Andante Amoroso - 3 bars


Mean of all onset difference (Midi synthesized-G Air-2 bars)
0 garbage = 0.057472555
1 garbage = 0.167695353
[20110114]
套一個衰減較快的簡單envelope似乎效果比較好一點


[20100112]
今天大家討論之後發現好幾個問題將midi note的能量套一個簡單的envelope,如圖:

目前發現有兩個地方因此有所改進:
1. 對於同時出現的pitch音,在DTW時有了改善,以440為例,在第二小節後半的部分第一聲部和第二聲部同時出現。
原本:

後來:

可以看出在2500的附近path有找到第二個peak。
2. 90度的dtw path 會有 midi frame 一對多個 wav frames 的情況,因此我們需要要訂立一個規則去選擇那一個frame是我們要的,onset部分看起來都是選第一個 frame是最好的,所以假設規則是選最前面的frame,但是在offset的時候卻可能差很多,如下圖。
原本:


[20110106]
todo :
1. midi中音符的地方能量改成"梯形"。
2. training一次後,使用initial W : 在某個時間點沒有其八度音的音,initial H : DTW的結果。
貼一下結果圖:


[20101230]
今天大家討論之後發現好幾個問題
1. 音檔比譜高了八度音
2. partial filter bands 忘記inverse
3. 音檔本身高頻就沒有能量
4. 左手應該是Do mi so,比譜多了一個E5。
(實際用鋼琴測試了一下,應該是有彈mi)
5. 多音可以用garbage template來解決,
少音卻可能會發生那個template吃掉別人的partial能量的現象。
更正一下結果圖:

‧λ=100的harmonic的效果不夠好,右邊的才有比較好的效果,
其中第一個template的第二根peak就是 Mi (E5)的基頻。
‧partial數很少是因為音檔本身的問題。
‧目前的五個template是代表 C5、G5、C6、E6、G6
可以發現八度音和五度音的問題確實會影響很大...
[20101229]
Input : (performance wav , piano )

使用鋼琴的演奏音檔,觀察頻譜發現這個樂器的特性不是f0能量最大而是partial 1。
NMF的結果,對照initial template的圖可以很明顯的發現partial跑掉了,將harmonicity cost function的 λ 加大也沒什麼效果..
[20101227]
Input data:First bar of "Back - Air on the G String" (wav synthesized by MIDI )

Only initial:# partial = 10, Gaussion distribution ( σ = 1)

With additional harmonic cost function (by hanyo):λ = 0.02

The mean of aboutsolute difference between the above two :
W = 1.0837e-007
H = 9.2215e-004
Initial template放了對的頻率之後,有沒有使用harmonicity cost function的結果看起來是差不多的。分的結果看起來不錯,但,也許是因為input是由Midi合成的關係?
[20101221]
論文報告
Parallelism in Dynamic Time Warping for Automatic Signature Verification


 平均差異值來看好像PSD好上一點,但PSD遇到長音感覺比較容易出錯,且chroma的異常值比較少。chroma在第344個錯誤可能真的是因為那個音的onset的能量太小。
但是在兩個paper中,有一點比較不一樣的地方是在DTW三個方向的weight。
PSD : (w0, w45, w90)=(1,2,1)
Chroma : (w0, w45, w90)=(1,1,1)
有點trick的是,因為是比min,(1,1,1)這樣的weight會比較傾向於走45度角,應該要讓它大一點畢竟走的距離是比較大的,可以看DTW path右上角的小小方區塊,一個走水平方向一個走斜對角方向,可能是此原因造成的差異,也許兩種都改成(1, sqrt(2), 1)會是比較公平的比較。
[20101112]
經由DTW path反推出alignment onset,與之前標的比較。圖為和alignment之後得到的onset與groundthruth onset比較的difference。
另外,因為使用的是typeI的DTW (0, 45, 90度),所以有可能會有一個midi frame對多個wav frame的情形,下圖分別是取中間frame、第一個frame、最後一個 frame來做為比較的差。
The mean of aboutsolute difference between the above two :
W = 1.0837e-007
H = 9.2215e-004
Initial template放了對的頻率之後,有沒有使用harmonicity cost function的結果看起來是差不多的。分的結果看起來不錯,但,也許是因為input是由Midi合成的關係?
[20101221]
論文報告
Parallelism in Dynamic Time Warping for Automatic Signature Verification
[20101216]
將NMF的template設為只能是譜上出現的音+額外具有特殊功能的template,update時加上harmonic的限制。
假設在NMF的結果不錯的原則上,
有兩種方法:
1. 整首歌會出現的pitch都有一個自己的template,得到結果之後,再做單音對單音的 alignment。每個H row,分別去對那個pitch的score,得到自己的alignment。所以音檔裡總共有幾個pitch就會做幾次DTW。
2. 判斷那一個時間點有哪些音,template的個數和其代表的pitch會隨之改變。不做DTW,直接將H的值來分析結果。
[20101213]
● 純MATLAB code的加速:
本來程式是依照這樣的公式寫,很直覺的就是用for loop針對matrix的每一個element去做計算。

後來依照我11/23所報的第一篇paper上面的公式,他把它寫成更矩陣的形式。
 [ref. Accelerating Non-negative Matrix Factorization for Audio Source Separation on Multi-core and Many-core Architectures]
改寫後在matlab上跑,參數:frame size = 8192,hop size = 256,# of templates = 10, # of frames = 769。
只計算update部分的時間,iteration = 100次。
origin : 297.644882 (sec)
modified:28.522258 (sec)
speedup:10.4355倍
竟然差了十倍,看來在matlab上真的要盡量用矩陣運算來取代for loop寫法!
● 在MATLAB上使用CUBLAS library的SGEMM(Single-precision GEneral Matrix Multiply):
矩陣相乘維度參數 m x k x n
假設 C=A*B,A : m x k,B:k x n,C:m x n
 每一列的意思:
左邊的參數會這樣設是仿造目前的參數W*H 來的,但這樣使用CUDA反而比MATLAB還要慢;右邊的實驗是想說資料維度大一點或許就會比MATLAB來的快,結果也如我想的。
接下來如果真的要使用mex & CUDA,應該不能一次矩陣相乘就呼叫一次,因為這樣資料要轉換型態、記憶體allocate還要搬好幾次,不划算。應該要寫一個把整個NMF過程都包含進去的API,最好是整個NMF都在GPU memory上面運作就好。
猜想11/23報的第一篇paper會比後面兩篇speedup來的小的原因是因為,他把每個operation拆開,每一個都寫成一個kernel function去執行,而後面兩篇可能是一次把事情做掉吧。
[20101206]
A Guide to Using NVMEX tool
可能因為os、matlab、vc版本不同,在這邊會出現一些錯誤。
首先,我使用的是VC9,但範例中是VC8,因此需要修改一下nvmexopts.bat的一些路徑,
怎麼修改請看此pdf中的第6點 (連結)。
再來出現的錯誤
nvcc fatal : Unknown option 'oC:\Users\Vivian\AppData\Local\Temp\mex_F9gfIA\test.obj'
看的出來因為路徑前面多了一個o所以找不到所需要的檔案。
只好去看一下nvmex.pl,把perl中的一些變數印出來看,發現是
$name_arg = $NAME_OBJECT . smart_quote($target_name);
$NAME_OBJECT這個變數的關係。
解決方法是把nvmexopts.bat中,
set NAME_OBJECT=-o 改成 set NAME_OBJECT=
也就是不給它值,就不會被干擾哩。
之後再compile,會發現會出現很多錯誤訊息,
google之後找到nvidia forums 有人和我有相同的問題! (連結)
將 nvmexopts.bat 中,
set COMPFLAGS=-c -D_WCHAR_T_DEFINED -Xcompiler "/c /Zp8 /GR /W3 /EHsc /Zc:wchar_t- /DMATLAB_MEX_FILE /nologo"
"/Zc:wchar_t- " 改為 "/Zc:wchar_t",也就是把"-"去掉,這樣雖然會出現一些warning,但是就可以compile過了!
感謝討論串中的eigma大大。
最後小小測試 fft v.s cufft,speed up大概是1.5~2.5左右。
[20101123]
報告
Frame size = 8192,hop size = 2048,DTW使用type I,與PSD的一樣。將NMF的template設為只能是譜上出現的音+額外具有特殊功能的template,update時加上harmonic的限制。
假設在NMF的結果不錯的原則上,
有兩種方法:
1. 整首歌會出現的pitch都有一個自己的template,得到結果之後,再做單音對單音的 alignment。每個H row,分別去對那個pitch的score,得到自己的alignment。所以音檔裡總共有幾個pitch就會做幾次DTW。
2. 判斷那一個時間點有哪些音,template的個數和其代表的pitch會隨之改變。不做DTW,直接將H的值來分析結果。
[20101213]
● 純MATLAB code的加速:
本來程式是依照這樣的公式寫,很直覺的就是用for loop針對matrix的每一個element去做計算。

後來依照我11/23所報的第一篇paper上面的公式,他把它寫成更矩陣的形式。

只計算update部分的時間,iteration = 100次。
origin : 297.644882 (sec)
modified:28.522258 (sec)
speedup:10.4355倍
竟然差了十倍,看來在matlab上真的要盡量用矩陣運算來取代for loop寫法!
● 在MATLAB上使用CUBLAS library的SGEMM(Single-precision GEneral Matrix Multiply):
矩陣相乘維度參數 m x k x n
假設 C=A*B,A : m x k,B:k x n,C:m x n

- MATLAB : 使用matlab指令A*B
- myAPI:我寫的matlab函式,透過MEX-file得到matlab的參數,因為matlab是double-presicion,要先轉換型態之後,再去使用cublas library,之後再把值傳回。
- Speedup:MATLAB time / myAPI time
- only CUBLAS:myAPI中,不去計算matlab矩陣轉換到cuda矩陣的時間。
- only cublasSgemm:only CUBLAS中,不去計算allocate cuda memory和搬運的時間,只計算lib中矩陣相乘函式cublasSgemm的時間。
左邊的參數會這樣設是仿造目前的參數W*H 來的,但這樣使用CUDA反而比MATLAB還要慢;右邊的實驗是想說資料維度大一點或許就會比MATLAB來的快,結果也如我想的。
接下來如果真的要使用mex & CUDA,應該不能一次矩陣相乘就呼叫一次,因為這樣資料要轉換型態、記憶體allocate還要搬好幾次,不划算。應該要寫一個把整個NMF過程都包含進去的API,最好是整個NMF都在GPU memory上面運作就好。
猜想11/23報的第一篇paper會比後面兩篇speedup來的小的原因是因為,他把每個operation拆開,每一個都寫成一個kernel function去執行,而後面兩篇可能是一次把事情做掉吧。
[20101206]
在Matlab上使用CUDA,可以參考Nvidia提供的pdf。
White Paper - Accelerating MATLAB with CUDA™ Using MEX Files
如果只要使用cuda提供的library,(ex. cufft)...等,那麼只需寫成.c檔就好了。
>> mex filename.c -IC:\CUDA\include -LC:\CUDA\lib -lcudart -lcufft
成功的話就會被compile成MEX-file(.mexw32)。
如果需要自己寫kernel function,要寫成cuda特有的.cu檔案才行,之後交給nvcc去compile。
White Paper - Accelerating MATLAB with CUDA™ Using MEX Files
如果只要使用cuda提供的library,(ex. cufft)...等,那麼只需寫成.c檔就好了。
>> mex filename.c -IC:\CUDA\include -LC:\CUDA\lib -lcudart -lcufft
成功的話就會被compile成MEX-file(.mexw32)。
如果需要自己寫kernel function,要寫成cuda特有的.cu檔案才行,之後交給nvcc去compile。
這時候需要使用一些plugin tool。
A Guide to Using NVMEX tool
可能因為os、matlab、vc版本不同,在這邊會出現一些錯誤。
首先,我使用的是VC9,但範例中是VC8,因此需要修改一下nvmexopts.bat的一些路徑,
怎麼修改請看此pdf中的第6點 (連結)。
再來出現的錯誤
nvcc fatal : Unknown option 'oC:\Users\Vivian\AppData\Local\Temp\mex_F9gfIA\test.obj'
看的出來因為路徑前面多了一個o所以找不到所需要的檔案。
只好去看一下nvmex.pl,把perl中的一些變數印出來看,發現是
$name_arg = $NAME_OBJECT . smart_quote($target_name);
$NAME_OBJECT這個變數的關係。
解決方法是把nvmexopts.bat中,
set NAME_OBJECT=-o 改成 set NAME_OBJECT=
也就是不給它值,就不會被干擾哩。
之後再compile,會發現會出現很多錯誤訊息,
google之後找到nvidia forums 有人和我有相同的問題! (連結)
將 nvmexopts.bat 中,
set COMPFLAGS=-c -D_WCHAR_T_DEFINED -Xcompiler "/c /Zp8 /GR /W3 /EHsc /Zc:wchar_t- /DMATLAB_MEX_FILE /nologo"
"/Zc:wchar_t- " 改為 "/Zc:wchar_t",也就是把"-"去掉,這樣雖然會出現一些warning,但是就可以compile過了!
感謝討論串中的eigma大大。
最後小小測試 fft v.s cufft,speed up大概是1.5~2.5左右。
報告
NMF on CUDA
[20101115]
實作chroma方法on MATLAB,依照Multi-pass...那一篇paper。


 平均差異值來看好像PSD好上一點,但PSD遇到長音感覺比較容易出錯,且chroma的異常值比較少。chroma在第344個錯誤可能真的是因為那個音的onset的能量太小。
但是在兩個paper中,有一點比較不一樣的地方是在DTW三個方向的weight。
PSD : (w0, w45, w90)=(1,2,1)
Chroma : (w0, w45, w90)=(1,1,1)
有點trick的是,因為是比min,(1,1,1)這樣的weight會比較傾向於走45度角,應該要讓它大一點畢竟走的距離是比較大的,可以看DTW path右上角的小小方區塊,一個走水平方向一個走斜對角方向,可能是此原因造成的差異,也許兩種都改成(1, sqrt(2), 1)會是比較公平的比較。
[20101112]
經由DTW path反推出alignment onset,與之前標的比較。圖為和alignment之後得到的onset與groundthruth onset比較的difference。
 difference error (seconds):

以下以取中位數frame的情況來分析,數字代表音符的index;
 如果說去除大於1.5秒的那3個值,重新計算difference平均 = 0.0937 s,大約是兩個frame 。
第344個音符是BWV1007這曲子中,中間長音之後的第一個音符,在演奏的音檔中,這個音符的onset音量很小。
 而第655、656個notes是曲子的結尾,是長音。

接下來有點想要在matlab上實作一次chroma的方法,比較一下這兩種方法對於BWV1007的結果如何。
[20101108]
Implement 6月7號所報告的論文,使用Matlab...令人感動的方便許多。
Implement 6月7號所報告的論文,使用Matlab...令人感動的方便許多。
Midi parser的部分感謝這個網站與它的主人


依然是先使用Bach BWV1007 prelude做實驗,wav是2分44秒,共656個notes。
圖中藍色線為spectrum,綠色線為band filters。上圖是wav的第2個frame vs midi的第2個frame,distance較小;下圖是wav的第10個frame vs midi的第220個frame,distance較大。
圖中藍色線為spectrum,綠色線為band filters。上圖是wav的第2個frame vs midi的第2個frame,distance較小;下圖是wav的第10個frame vs midi的第220個frame,distance較大。
論文中的hop size為256,所以有5.8ms的resolution。
可是如果這樣的話,matlab記憶體會不夠,因為矩陣變得相當大;且論文中提及他實驗的一首兩分半的巴哈小提琴獨奏,就需要2GB的記憶體,但筆電的RAM也才2GB...
所以先使用frame size = 8192,hamming window,hop size = 2048。
 左邊是distance的矩陣,顏色越深代表越相似;
右邊紅色線是DTW找出來的對應路徑,0度, 45度, 90度的 typeI,weight=[1,2,1],頭對頭、尾對尾;此外記錄一下一些參數 thetaD = 0.5, thetaS = 0.5, ss = 1, sd = 1。
可以發現結果和左邊用肉眼看出的由distance小的element所那條組合成的線很相近,不過這也只能說是DTW找出來的path和最小cost真的很符合而已。
要知道結果好不好,還是要和ground truth(之前用cool edit標的)比較,下一步應該要把cue的資訊弄進matlab計算正確率。
[20100608]
Q:
我有一個spectrum,已知裡面的某一個f0,想要知道它是不是單音且為harmonic ?
A:
1. filter : 因為知道f0,在每個倍頻上用 gaussian 去 model 每個 peak
2. 計算 : spectrum 的總能量 - spectrum 經過 filter 後的能量
3. 如果是單音且為harmonic,那麼剩下的能量應該會很小。
除了之前看的chroma feature,也有好一些人是使用這篇論文提出來的方法。這篇論文是2001年publish的,它提出了一個名為 Peak Structure Distance(PSD) 的 feature,這個Distance用來當作DTW中的local distance使用,相對於之前我們的作法就是用來取代Euclidean distance。
PSD簡單來說,就是去算score frame與 audio frame 的peak的相似度,越相近distance越小。另外它還model了一個note的開始 (attack model) 與 結束 (silence model) 。
它做了很多仔細的實驗和數據,結果看起來不錯,感覺上還蠻值得參考的。下次會看也是由Ircam在2003年發表的paper,關於這個方法提出的改進。
[20100604]
以 Mozart piano sonata K.545 的前四小節為測試曲子,修改 midi 來合成測試的 wav。
Midi 合成 wav 軟體 : WinGroove
目前ground truth : Calkwalk 看 event list -> Cool Edit 人工標記
(未來:不執著於要存到wav裡的cue,用另外的檔案代替儲存。)
新增輸出 onset error 詳細資料的 html table。
測試了合成時有無reverberation、某個時間點譜不只一個音出現但audio其中一個音比譜晚出現半拍的情況。
進度投影片
link由於想了解DTW在一些特定的情況之下會有怎樣的行為,因此我用midi式的chroma feature來作實驗,測試了比原本的 chroma 多音、少音、平移幾個半音,對於兩種 type 的 DTW 會有怎樣的結果。
另外也測試了 piano 與 trumpet 的片段。
進度投影片
link[20100503]
論文報告
Handling Asynchrony in Audio-score Alignment
投影片
[20100430]
現在的目標,是讓score alignment夠準,然後能自動截取audio中每個音的起始時間,還有結束時間,它的f0和partials的frequency、amplitude,來做合成使用。
論文報告
Handling Asynchrony in Audio-score Alignment
投影片
[20100430]
現在的目標,是讓score alignment夠準,然後能自動截取audio中每個音的起始時間,還有結束時間,它的f0和partials的frequency、amplitude,來做合成使用。
新增輸出 cue 詳細資料的 html table、輸出 alignment 結果所對應的midi、wave 之 frame、second 的 html table。
程式有bug待修。
程式有bug待修。
進度投影片
link
[201003022]
論文報告
GPU ...
[20100204]
兩件事情:解決讀midi的bug、score alignment的onset時間 v.s 人工標記的onset時間。
1. 讀midi的bug : 在某些時候會少讀了一些長度
發現依然是讀檔時,byte轉換發生的問題,java的byte是signed,所以當值大於127它就會變成負的,再去做排列就會錯。這個問題之前也發生在讀wav的時候,用一樣的方式解決就好了。
更正一下上次po的圖,BWV1007前兩小節(點圖可放大)
midi :
 wav origin :
 wav considering partials :

2. score alignment 結果的onset時間 v.s 人工標定的onset時間
FFT frame size : 4096
hop size (兩個frame起始位置間隔) : 512
表格裡面的值 (秒) :
|score alignment 結果 - 人工標定的onset時間| / 總共onset個數

可以發現前四組結果,有考慮partials的方法會比沒有考慮來的好一些,
但是如果是整首BWV1007來做比對,兩者結果都變差許多,而且有考慮partials的方法結果還變得比沒有原始的方法差。
對於整首的這組結果來觀察,發現平均值增大的原因可能是因為有幾個onset的差異比平均大許多,大概一秒鐘左右。而有考慮partials的方法差異大的onset比原始方法的這種情況還要多。
新方法大約310-343+後面24個onset誤差較大,原始方法大約323-343+後面20個onset誤差較大所致。第343個onset對於BWV1007剛好是歌曲的段落,是一個長音,而且BWV1007這首歌除了中間和最後的兩個音是長音,其它都是16分音符,不曉得是不是因為這個原因讓判斷變差。
[20100120]
論文報告
Music Score Alignment and Computer Accompaniment
投影片


[20091221]
首先是解決冠廷學長之前沒處理到的部分:由於 map 到每個 pitch class 的 bin 數量不會一樣,所以要做一次 normalize 的動作。
左邊圖片是原本的,右邊是有加上取平均。(也就是傳統chroma)
1. white noise
 2. BWV1007-15s

之後就作新加的部分,要往上加 partial 能量,也加上了 normalize 取平均的步驟。
以 BWV1007 前 15s 為例:
1. original
 2. 每個 bin 從 frequency domain 中找最接近的partial's bin,加總其能量並取平均。
 3. 每個 pitch 從 frequency domain 中找最接近的 partial's bin,加總其能量並取平均。(花較少時間)
 目前以第三個方法為主。
上面三個圖之間似乎沒有很大的變化,
第二個比較稍微不一樣一點,第一個圖和第三個圖只有些微差距。
令人在意的是第二個音,譜是 RE,但是卻是五度音的 LA 能量較強,用了新的方法依然沒解決這個問題,這蠻出乎意料的。後來印出一些資料來看,發現可能是threshold設太小的問題。
這個threshold是用於判別這個bin是不是目前基頻的partial:
| (bin frequency/基頻) - ((bin frequency/基頻)最接近的整數) | <= threshold 所以我試著將 threshold 從0.001 調整為 0.1,第二個音 RE 就出現了! 對譜的結果也比之前的好

[20091217]
論文報告
Audio Thumbnailing of Popular Music Using Chroma-Based Representations
投影片
[20091216]
與老師討論了一下,以後可能有兩個方向可以走。
1. 假設 midi 是對的。
我們可以經由 DTW 的 cost 去調整 partial 的比例,也可以說是 chroma template 的 weighting 參數,以貼近現在樂器的特性。
比如說現在這把大提琴第三個partial的能量會特別高,希望可以經由 DTW cost feedback 來調整我們的 chroma template 的參數。
2. 假設知道是什麼樂器,而且只適用在這首歌只有一種樂器上,但是這樂器可以是多音。
(1) 把 midi 經由這樂器的音色庫,合成出符合這樂器的 wav,轉成 chroma 後再進行對譜。
(2) 由 wav 來建 instrument model,藉由這個來讓 chroma 更準確。
[20091211]
看了老師的回應,和小明學長討論了一下,預計的做法是:
FFT(4096) -> map 2048個bin到最接近的 pitch -> 每個pitch從frequency domain中找最接近的partial's bin,加總其能量,取平均。
這樣應該會減少一些計算量。
[20091209]
為了解決五度音等partial重疊導致能量貢獻給別的音名的問題,但是又想要維持使用chroma,也不想要在這裡使用pitch detection等較複雜的演算法。經過討論之後,決定現在多一個步驟的做法:讓每個頻率往上找它的partial,把其能量加起來到自己身上,這樣重疊的partial能量就會貢獻到可能是它的f0的身上。
流程 :
FFT (size:4096) → Map 每個 bin 到最接近的 pitch frequency → 每個 bin 往上找倍頻的能量並加到自己本身 → 每個 bin 分配到 chroma vector
我們使用的pitch frequency table是參考wiki的音高頻率表
另外就是這個演算法花的時間很久...
結果:
 發現最下面那條Do的pitch class的能量一直非常大。
後來發現是因為第一個bin大約是10.7666Hz左右,然而第一個bin一定是所有bin頻率的因數,對照pitch frequency table,10.7666Hz最接近的是C0(DO),因此它的能量因此會最大。
忽略了第一根bin的結果:
 發現變成是往上數第六條的能量最大,對照音名是FA。這是因為第二根bin也是好多bin們的因數,第二根bin頻率大約是21.5332Hz,對照表最接近的是F0,因此得知。
後來和小明學長討論發現了另一個問題,都是關於應該需要去取平均的地方。
1. 冠廷學長做Chroma的方式,如果是採用每根bin就map到跟它頻率最接近的那個音之後加起來,那麼事實上他可能忽略了一個問題,低頻的部分兩根bin中間可能有好多的音在那個範圍,在高頻的部分可能在兩個音的範圍中間會有好多根bin,因此會有每個音所擁有的bin會不同數量的問題,我們實驗用white noise當作input,真的發現chroma的顏色並沒有分布的很均勻。所以應該要讓每個音除以它所擁有的bin的個數,取平均。
2. 在我們新加的方法中,低頻的bin會有較多的partial,所以能量加到自己身上之後,應該也要除以partial的個數來取平均。雖然這樣當能量懸殊的時候還是會造成彼此相對的差異減少,不過總是比沒有做normalize來的正確一些。
[20091201]
用BWV1007前四小節去跑,發現wav chroma錯誤了。
1. 前兩個音SO(低)、RE的部分,推論是因為五度音的關係,f0相差1.5倍,因此倍頻重疊了,RE的部分能量被認為是 SO 的。
2. 後面四個音也錯了,變成都是LA,推測是因為frame size不夠大,造成 fft 後頻率域的resolution不夠高。
origin frame size : 2048

frame size : 4096

frame size : 8192

可以看出增加frame size以增加frequency的解析度,結果準確許多。
不過第二個音 RE 的部分為什麼chroma顯示出來是 LA 的能量最強呢,是因為 RE 和 LA 是五度音嗎?
但是觀察spectrum,發現440 Hz左右真的有一條能量強的partial,所以不只是 RE 和 LA 第一個重疊的倍頻880Hz所分配給 LA 的部分。
[201003022]
論文報告
GPU ...
[20100204]
兩件事情:解決讀midi的bug、score alignment的onset時間 v.s 人工標記的onset時間。
1. 讀midi的bug : 在某些時候會少讀了一些長度
發現依然是讀檔時,byte轉換發生的問題,java的byte是signed,所以當值大於127它就會變成負的,再去做排列就會錯。這個問題之前也發生在讀wav的時候,用一樣的方式解決就好了。
更正一下上次po的圖,BWV1007前兩小節(點圖可放大)
midi :
 wav origin :
 wav considering partials :

2. score alignment 結果的onset時間 v.s 人工標定的onset時間
FFT frame size : 4096
hop size (兩個frame起始位置間隔) : 512
表格裡面的值 (秒) :
|score alignment 結果 - 人工標定的onset時間| / 總共onset個數

可以發現前四組結果,有考慮partials的方法會比沒有考慮來的好一些,
但是如果是整首BWV1007來做比對,兩者結果都變差許多,而且有考慮partials的方法結果還變得比沒有原始的方法差。
對於整首的這組結果來觀察,發現平均值增大的原因可能是因為有幾個onset的差異比平均大許多,大概一秒鐘左右。而有考慮partials的方法差異大的onset比原始方法的這種情況還要多。
新方法大約310-343+後面24個onset誤差較大,原始方法大約323-343+後面20個onset誤差較大所致。第343個onset對於BWV1007剛好是歌曲的段落,是一個長音,而且BWV1007這首歌除了中間和最後的兩個音是長音,其它都是16分音符,不曉得是不是因為這個原因讓判斷變差。
[20100120]
論文報告
Music Score Alignment and Computer Accompaniment
投影片
[20091231]
BWV 1007前2小節對譜全圖 (點圖可放大)
BWV 1007前2小節對譜全圖 (點圖可放大)
沒加新方法的 wav :

有往上加 partial 的 wav :

midi :

可以看出,有加了往上疊加 partial 能量方法的對譜效果比較好,
最後面的部分沒對好,是因為 midi parser 那部分有些問題,最後面少讀了一些音。
所以接下來要幫 midi parser 的部分code debug。
→ check 完學長原本的 c# 程式應該是對的,所以可能是改到 java 的時候不知道哪裡改錯了... (20100105)
→ check 完學長原本的 c# 程式應該是對的,所以可能是改到 java 的時候不知道哪裡改錯了... (20100105)
[20091221]
首先是解決冠廷學長之前沒處理到的部分:由於 map 到每個 pitch class 的 bin 數量不會一樣,所以要做一次 normalize 的動作。
左邊圖片是原本的,右邊是有加上取平均。(也就是傳統chroma)
1. white noise
 2. BWV1007-15s

之後就作新加的部分,要往上加 partial 能量,也加上了 normalize 取平均的步驟。
以 BWV1007 前 15s 為例:
1. original
 2. 每個 bin 從 frequency domain 中找最接近的partial's bin,加總其能量並取平均。
 3. 每個 pitch 從 frequency domain 中找最接近的 partial's bin,加總其能量並取平均。(花較少時間)
 目前以第三個方法為主。
上面三個圖之間似乎沒有很大的變化,
第二個比較稍微不一樣一點,第一個圖和第三個圖只有些微差距。
令人在意的是第二個音,譜是 RE,但是卻是五度音的 LA 能量較強,用了新的方法依然沒解決這個問題,這蠻出乎意料的。後來印出一些資料來看,發現可能是threshold設太小的問題。
這個threshold是用於判別這個bin是不是目前基頻的partial:
| (bin frequency/基頻) - ((bin frequency/基頻)最接近的整數) | <= threshold 所以我試著將 threshold 從0.001 調整為 0.1,第二個音 RE 就出現了!
 對譜的結果也比之前的好

[20091217]
論文報告
Audio Thumbnailing of Popular Music Using Chroma-Based Representations
投影片
[20091216]
與老師討論了一下,以後可能有兩個方向可以走。
1. 假設 midi 是對的。
我們可以經由 DTW 的 cost 去調整 partial 的比例,也可以說是 chroma template 的 weighting 參數,以貼近現在樂器的特性。
比如說現在這把大提琴第三個partial的能量會特別高,希望可以經由 DTW cost feedback 來調整我們的 chroma template 的參數。
2. 假設知道是什麼樂器,而且只適用在這首歌只有一種樂器上,但是這樂器可以是多音。
(1) 把 midi 經由這樂器的音色庫,合成出符合這樂器的 wav,轉成 chroma 後再進行對譜。
(2) 由 wav 來建 instrument model,藉由這個來讓 chroma 更準確。
[20091211]
看了老師的回應,和小明學長討論了一下,預計的做法是:
FFT(4096) -> map 2048個bin到最接近的 pitch -> 每個pitch從frequency domain中找最接近的partial's bin,加總其能量,取平均。
這樣應該會減少一些計算量。
[20091209]
為了解決五度音等partial重疊導致能量貢獻給別的音名的問題,但是又想要維持使用chroma,也不想要在這裡使用pitch detection等較複雜的演算法。經過討論之後,決定現在多一個步驟的做法:讓每個頻率往上找它的partial,把其能量加起來到自己身上,這樣重疊的partial能量就會貢獻到可能是它的f0的身上。
流程 :
FFT (size:4096) → Map 每個 bin 到最接近的 pitch frequency → 每個 bin 往上找倍頻的能量並加到自己本身 → 每個 bin 分配到 chroma vector
我們使用的pitch frequency table是參考wiki的音高頻率表
另外就是這個演算法花的時間很久...
結果:
 發現最下面那條Do的pitch class的能量一直非常大。
後來發現是因為第一個bin大約是10.7666Hz左右,然而第一個bin一定是所有bin頻率的因數,對照pitch frequency table,10.7666Hz最接近的是C0(DO),因此它的能量因此會最大。
忽略了第一根bin的結果:
 發現變成是往上數第六條的能量最大,對照音名是FA。這是因為第二根bin也是好多bin們的因數,第二根bin頻率大約是21.5332Hz,對照表最接近的是F0,因此得知。
後來和小明學長討論發現了另一個問題,都是關於應該需要去取平均的地方。
1. 冠廷學長做Chroma的方式,如果是採用每根bin就map到跟它頻率最接近的那個音之後加起來,那麼事實上他可能忽略了一個問題,低頻的部分兩根bin中間可能有好多的音在那個範圍,在高頻的部分可能在兩個音的範圍中間會有好多根bin,因此會有每個音所擁有的bin會不同數量的問題,我們實驗用white noise當作input,真的發現chroma的顏色並沒有分布的很均勻。所以應該要讓每個音除以它所擁有的bin的個數,取平均。
2. 在我們新加的方法中,低頻的bin會有較多的partial,所以能量加到自己身上之後,應該也要除以partial的個數來取平均。雖然這樣當能量懸殊的時候還是會造成彼此相對的差異減少,不過總是比沒有做normalize來的正確一些。
[20091201]
用BWV1007前四小節去跑,發現wav chroma錯誤了。
1. 前兩個音SO(低)、RE的部分,推論是因為五度音的關係,f0相差1.5倍,因此倍頻重疊了,RE的部分能量被認為是 SO 的。
2. 後面四個音也錯了,變成都是LA,推測是因為frame size不夠大,造成 fft 後頻率域的resolution不夠高。
origin frame size : 2048

frame size : 4096

frame size : 8192

可以看出增加frame size以增加frequency的解析度,結果準確許多。
不過第二個音 RE 的部分為什麼chroma顯示出來是 LA 的能量最強呢,是因為 RE 和 LA 是五度音嗎?
但是觀察spectrum,發現440 Hz左右真的有一條能量強的partial,所以不只是 RE 和 LA 第一個重疊的倍頻880Hz所分配給 LA 的部分。
→ 440Hz是這裡的 RE(146.83Hz) 的三倍頻沒錯,之前誤以為是它的高八度 RE(293.66Hz) ,而它的三倍應該是880Hz,所以才會疑惑為什麼會有440Hz的強能量。(20091202)
(按圖可放大)
 另外,SO 的能量一直很強,造成餘音的效果。雖然譜上看起來是單音的樂曲,但是實際上是多音。可能是因為樂器的特性,第三個partial的能量特別強。
目前把頻率域的值map到chroma gram的方法是,準備一個10個八度音的frequency tabel,然後就去對和哪個pitch最接近,再map到chroma vector。
這樣的方法,五度音的partial能量會分配給兩者頻率較高的那一個。ex. RE (293.66Hz)的第三個partial、LA(440Hz)的第二個partial,大約是880Hz,而880Hz對照frequency tabel是LA。
但是學長也提到,如果採用傳統f0 detection的投票方法,那麼五度音的重疊partial能量會分配給兩者頻率較低的那一個音。
學長建議,接下來有兩條路。
第一條路,去解決五度音在chroma vector上表現的問題。
另一條路就是略過五度音的問題,找個沒有五度音的片段,往下找DTW在對譜時所展現的特性,也就是找DTW在對錯譜前後的參數變化情況。
[20091128]
把DTW 的matrix印出來。
本來是要印成文字檔,但是實在不好觀察,所以就做了另一個可以輸出成HTML的版本,這樣可以用簡單的方式去讓印出來的tabel上色和排列。
 不過table真的很大,光是一分多鐘的dtw table的txt檔案,就可以達到450MB左右。
以下是用BWV1007前四小節的結果。
type 1 :


type 2 :


粉紅色底的格子是代表dtw找出來的path。
[20091124]
標音檔的SOP(手稿)

工作畫面
上方是cool edit,左邊是cue list(Desc欄寫pitch),下方是catwalk,主要是拿來顯示譜。

[20091122]
標好了巴哈無伴奏大提琴BWV 1007 Prelude,大約兩分五十秒,655個音,655個cue。
每個cue我都給他一樣的長度(4096個sample),因為要抓住那個音是哪個瞬間出現的有點難,所以後來決定去抓換音的瞬間,因為換音耳朵比較好辨認,所以我想起頭音的時間點就設cue的中點。
小筆記:
1. 20小節的地方音檔或譜似乎有錯,
音聽起來是do# la mi fa so mi fa so
譜是do# la do re mi do re mi
觀察DTW的時候可以注意一下這地方。
(應該是midi錯,因為去找過youtube上面的影片聽過跟wav是一樣的)
2. 發現mi不知道為什麼波形amplitude都比較大
3. 同一個音連續出現的話有點難聽出onset,所以是看波型來標。
之後,用之前的java程式去跑跑看,在作DTW一直出現例外 java.lang.OutOfMemoryError: Java heap space,有試著逐步幫JVM加大他的記憶體,但是還是出現一樣的例外。
所以我就想知道這樣的長度DTW到底需要多大的記憶體,就用學長之前的C#程式去跑,發現DTW大概吃掉1.5G左右的記憶體。可是給JVM這麼大的記憶體參數,會顯示無法建立的訊息。
目前wav的frame size是沿用學長的2048 overlap 512,想改成4096 overlap 2048,這樣可以減少frame的數量。此外midi是用一個tick當作一個frame,所以frame的數量很大。因此兩者所構成的DTW matrix使用的空間是很大的。
[20091112]
論文報告
An Efficient Multiscale Approach to Audio Synchronization
投影片
[20091023]
讀cue的程式寫好了,用 java去改寫,因為想說之前的chroma部分也是用java來做。
結果大概如下圖,測試的是原本語音的檔案。

因為我們的目的是要知道onset,所以對於cue來說,我們需要的就只是某個cue的起始時間。所以學長建議我,在幫音樂wav標onset的時候,cue的長度用很短就可以了。
現在我先著手標記巴哈無伴奏BWV1007的onset,因為它是單一樂器,而且它的節奏不會很快,可能會比較容易。現在覺得有個問題就是...要抓住並判斷音出現的那瞬間真的有點難@@
[20091006]
為了可以在wav上面標記出正確的onset作為比對資料,和小明學長去了吳老師實驗室詢問了一下,知道了可以用cool edit直接在wav檔裡面記錄cue list,方法很簡單,就是用滑鼠選取這個cue的範圍,然後按下F8就可以了。
學姊也給了一隻他們之前寫的程式給我,是用VC6+MFC環境寫的關係,還有它的output有用到資料庫,我的電腦上執行不起來,所以想說自己來改寫一個。
[20090924]
論文報告
Polyphonic Audio Matching and Alignment for Music Retrieval
投影片
[20090924]
學長的程式已經轉換到java完畢。
以前的程式架構,是每個步驟都是分散手動進行。

然後我現在把它整合在一起。
 Improvement :
1. 整合、連貫各個project的功能。
2. 自行從GUI選擇讀取的檔案,不再受限於固定名稱。
3. draw onset frames
4. 可以使上下兩個scroll bar同步移動方便對照
程式畫面和流程 :

[20090908]
[20090831]


比起最之前的寫法,是多了把在smaple裡的lower byte & 0xff 這個步驟,因為這樣可以先確保他會先轉換成是一個positive的int,再轉換成short,這樣值就不會錯。如果直接轉換的話,他可能會認為byte值是負的然後就轉換到一個不正確的short,之後higher byte再往左移8 bit之後合併數值會有問題。之後也確認了這個方法與MATLAB的值一致。


 另外,SO 的能量一直很強,造成餘音的效果。雖然譜上看起來是單音的樂曲,但是實際上是多音。可能是因為樂器的特性,第三個partial的能量特別強。
目前把頻率域的值map到chroma gram的方法是,準備一個10個八度音的frequency tabel,然後就去對和哪個pitch最接近,再map到chroma vector。
這樣的方法,五度音的partial能量會分配給兩者頻率較高的那一個。ex. RE (293.66Hz)的第三個partial、LA(440Hz)的第二個partial,大約是880Hz,而880Hz對照frequency tabel是LA。
但是學長也提到,如果採用傳統f0 detection的投票方法,那麼五度音的重疊partial能量會分配給兩者頻率較低的那一個音。
學長建議,接下來有兩條路。
第一條路,去解決五度音在chroma vector上表現的問題。
另一條路就是略過五度音的問題,找個沒有五度音的片段,往下找DTW在對譜時所展現的特性,也就是找DTW在對錯譜前後的參數變化情況。
[20091128]
把DTW 的matrix印出來。
本來是要印成文字檔,但是實在不好觀察,所以就做了另一個可以輸出成HTML的版本,這樣可以用簡單的方式去讓印出來的tabel上色和排列。
 不過table真的很大,光是一分多鐘的dtw table的txt檔案,就可以達到450MB左右。
以下是用BWV1007前四小節的結果。
type 1 :


type 2 :


粉紅色底的格子是代表dtw找出來的path。
[20091124]
標音檔的SOP(手稿)

工作畫面
上方是cool edit,左邊是cue list(Desc欄寫pitch),下方是catwalk,主要是拿來顯示譜。

[20091122]
標好了巴哈無伴奏大提琴BWV 1007 Prelude,大約兩分五十秒,655個音,655個cue。
每個cue我都給他一樣的長度(4096個sample),因為要抓住那個音是哪個瞬間出現的有點難,所以後來決定去抓換音的瞬間,因為換音耳朵比較好辨認,所以我想起頭音的時間點就設cue的中點。
小筆記:
1. 20小節的地方音檔或譜似乎有錯,
音聽起來是do# la mi fa so mi fa so
譜是do# la do re mi do re mi
觀察DTW的時候可以注意一下這地方。
(應該是midi錯,因為去找過youtube上面的影片聽過跟wav是一樣的)
2. 發現mi不知道為什麼波形amplitude都比較大
3. 同一個音連續出現的話有點難聽出onset,所以是看波型來標。
之後,用之前的java程式去跑跑看,在作DTW一直出現例外 java.lang.OutOfMemoryError: Java heap space,有試著逐步幫JVM加大他的記憶體,但是還是出現一樣的例外。
所以我就想知道這樣的長度DTW到底需要多大的記憶體,就用學長之前的C#程式去跑,發現DTW大概吃掉1.5G左右的記憶體。可是給JVM這麼大的記憶體參數,會顯示無法建立的訊息。
目前wav的frame size是沿用學長的2048 overlap 512,想改成4096 overlap 2048,這樣可以減少frame的數量。此外midi是用一個tick當作一個frame,所以frame的數量很大。因此兩者所構成的DTW matrix使用的空間是很大的。
[20091112]
論文報告
An Efficient Multiscale Approach to Audio Synchronization
投影片
[20091023]
讀cue的程式寫好了,用 java去改寫,因為想說之前的chroma部分也是用java來做。
結果大概如下圖,測試的是原本語音的檔案。

因為我們的目的是要知道onset,所以對於cue來說,我們需要的就只是某個cue的起始時間。所以學長建議我,在幫音樂wav標onset的時候,cue的長度用很短就可以了。
現在我先著手標記巴哈無伴奏BWV1007的onset,因為它是單一樂器,而且它的節奏不會很快,可能會比較容易。現在覺得有個問題就是...要抓住並判斷音出現的那瞬間真的有點難@@
[20091006]
為了可以在wav上面標記出正確的onset作為比對資料,和小明學長去了吳老師實驗室詢問了一下,知道了可以用cool edit直接在wav檔裡面記錄cue list,方法很簡單,就是用滑鼠選取這個cue的範圍,然後按下F8就可以了。
學姊也給了一隻他們之前寫的程式給我,是用VC6+MFC環境寫的關係,還有它的output有用到資料庫,我的電腦上執行不起來,所以想說自己來改寫一個。
[20090924]
論文報告
Polyphonic Audio Matching and Alignment for Music Retrieval
投影片
[20090924]
學長的程式已經轉換到java完畢。
以前的程式架構,是每個步驟都是分散手動進行。

然後我現在把它整合在一起。
 Improvement :
1. 整合、連貫各個project的功能。
2. 自行從GUI選擇讀取的檔案,不再受限於固定名稱。
3. draw onset frames
4. 可以使上下兩個scroll bar同步移動方便對照
程式畫面和流程 :

[20090908]
學長的MidiParser專案轉換到java已完成,得到的結果也和學長的一致。bug仍然是出在byte的問題,不過由於上次的經驗,這次解決就快多了。
這個專案的功用是:讀取midi file並分析,得到midi的chroma,也輸入了上個步驟得到的wav chroma,將兩個chroma做DTW,最後輸出onset的資料。
另外發現學長midi的delta-time(variable-length quantity)算法好像有些錯誤。這部分還需要find out。
→ 學長沒有錯,是我誤解code的意思。 (20090909)
[20090831]
首先確定JAVA和C的input stream對於wav值都是使用同樣排列方法。
使用上次說的網站的方法去做會有問題,因為它這樣出來的值全部都會是正數,這樣不是我們想要的結果。所以我們要偵測第二個byte的highest bit是0還是1,如果是1的話,代表這是一個負數,所以我們在幫int的最高和第二高的byte補上1。
由此得到的int就是我們要的sample。和MATLAB的值對照過,兩者是相同的。
另外這是如果我們每一個sample想用short去存的方法。(最初是用short)
最後使用的是網路上找的java FFT code,學長使用的FFT code的結果,虛部會差一個正負號,但是因為我們用的是能量值所以不會影響到chroma。不過我不確定我找的那個是不是open source,能否自由使用...
能解決這個問題感謝DNA與小明學長的幫忙。接著我開始來改MIDI Parser的部分,找到了java有提供javax.sound.midi這個package,試看看能不能拿來在這個部分使用。
[20090824]
把兩邊程式的FFT結果印出來,發現值真的不同,著手改寫冠廷學長使用的c# FFT sourse code改成JAVA,錯誤還是存在。後來小明學長建議用MATLAB裡的wavread還有fft function去做,把從MATLAB得到的wav還有fft值分別和C#、JAVA讀到的wav之後用MATLAB fft做的結果去比較。
結果是發現JAVA的是在讀取wav檔的值就有錯了,每一個frame裡錯誤的個數、index都不一定,錯誤的element值和正確的值相差的都是256的倍數,目前測試結果最大可差別到256*8=2048。猜想可能是overflow之類的問題。
Google到這個網址,Reading and Writing Wav Files in Java,它說因為JAVA不像C語言,沒有unsigned type的設計,都是two's Complement,所以使用java的File-IO得到的資料還要經過處理,他提供的解法是比如說2 bytes的short 就用4 bytes的int來代替,int用long來代替。這個可能就是我們的問題所在,會用此方法來試試看。
[20090818]
與冠廷學長交接之後,開始著手改寫程式從C#轉到JAVA,這是為了將來可以使用在authoring tool上。目前改寫至可以運作的部分有:
1. Read wav file → FFT → Chroma Vector
2. Music Library
但是比對我的程式和學長的程式對同一個wav檔案所轉出來的chroma,發現能量最高(=1, because of normalization) 的地方在某一時間區段是不同的,後來覺得只比對能量=1的地方好像不是很好,所以以下是用圖片來呈現。發現c#的結果乾淨許多…
c#
java
由於學長程式的FFT是使用c#的open source code,我目前java的版本也是先使用外面找的java code,所以推測可能是在FFT這步驟出現不同所以導致結果不一致。老師建議把先FFT的結果印出來作驗證。
[20090714 by SCREAM Lab, NCKU, Taiwan. 位於 下午 6:08]
在MIREX2008裡面有一個比賽項目叫做Score Alignment, 網址如下:
MIREX2008 Score Alignment or Score Following
其實就是冠廷學長的論文其中的一部分. 冠廷用的是Chroma Feature, 其論文我們過一陣子再Post出來, 但是我們一貫的討論可以在下面看到:
冠廷的Polyphonic Music Information Retrieval
這個問題對我們很重要, 不過一般的Score Alignment做的要是能從頭Follow到尾, 也就是冠廷做的. 研究上當然是要如此完整, 但是假如以短時間內能用到我們要做的應用, 那麼是可以有一些妥協的. 比如說, 我們可以讓使用者把一段Wave框起來, 在讓它來對Target的譜子, 而且一次只要對一部分的譜就好, 例如四小節, 八小節, 長短就看我們的演算法的好壞.
這個串今天由我來起個頭, 接下來就由小聽來接續. 我建議可以將冠廷學長的方法先弄起來, 然後找其他人的論文來Implement, 久了後, 相信會越做越好, 也許有一天我們也可以去參加比賽.
另外就是Score Alignment會是Authoring tool的一部分.


