======================11/25=======================
meeting投影片
延續上禮拜做的給做完。之前的loop因為寫得太單調了所以感覺沒用到幾個branch instruction,改的複雜一點就可以看出差別:
Function call -> LJMP, RET
while loop -> SJMP, CJNE
For loop -> SJMP, JNC
If-else -> JZ, JNZ
但仍然有少數的branch instruction我試不出來。最後沒辦法只好寫inline assembly自己測試:
ACALL, AJMP, LCALL, DJNZ, JB, JNB, JBC
======================11/18=======================
實作decoder加入判斷branch目標位子的功能。測試程式我是寫了簡單的while loop, for loop, 和function call來測試,但是看了對應的assembly code發現有些branch指令還是沒測到。之後會直接inline assembly繼續測試。
======================11/10=======================
寫了一個簡的測試程式,把每一行C code設breakpoint測試,都有停下來。同理用next step一步步執行也都有停到預期的program address;除了branch instruction。
因為只能根據目前的instruction長度判斷下一個instruction的位子來設定breakpoint,如果停下的點是branch instruction,則設定的breakpoint位子可能是執行不到的。譬如無限迴圈while(1);在assembly code就只是sjmp當下位子,我breakpoint則會設定到迴圈之外。
簡決方法是單步執行的decoder還必須能判斷branch的位子。
======================11/04=======================
原本Breakpoint的指令是用timer達成,現在已經改成學長的建議用software interrupt: SETB TF0。
上禮拜關於GDB的單步執行(next)會卡死的原因,發現單步執行所給予的breakpoint位子不可能走的到,我判斷是GDB端的問題。GDB處理signal step的地方當初是直接延用bbb的risc32,也就是判斷下一個instruction的位子是目前PC直接+4,所以才會造成GDB會產生一個不可能走到的breakpoint。又因為8051是CISC,下一個instruction的位子等於目前PC值加上目前instruction的長度,所以加上一個簡單的decoder判斷目前instruction的長度。
目前build GDB失敗......
======================10/28=======================
主要是實作8051 stub處理breakpoint的問題。8051 stub接到breakpoint指令後,啟動timer0 interrupt。利用timer interrupt每執行一個instruction都進handle_exception()檢查目前PC值和之前設定的breakpoint是否相同。
不同則表示還沒到breakpoint,return。
相同則表示已經走到breakpoint,進入無限迴圈等待GDB的指令。
目前測試看來是成功的,不過奇怪的是GDB的單步執行(next)會卡死,懷疑可能是GDB端給的program memory address有誤,目前還在debug。
======================10/21=======================
處理breakpoint之前,我想先完成單步執行的功能,因為breakpoint可以利用單步執行,每執行一instruction就比對一次目前的PC值是否和breakpoint table裡任一數值相吻合。
另一方面,GDB的單步執行(next)也差不多是如此;GDB的繼續指行(continue)就是跳出handle_exception繼續執行直到遇到breakpoint後又進去handle_exception。GDB的單步執行(next)則是根據symbol table知道下一步instruction的位子,設定breakpoint在那位子後,繼續執行(continue)。
處理單步執行我是用timer0 interrupt,簡單的驗證方式是觀察每一步的PC差距,更進一步應該是要比對binary code的instruction。還沒完成是因為遇到bug,應該只是個小錯誤,還在debug中。======================10/16=======================
我試著插入breakpoint於測試程式中,觀察設定breakpoint後GDB傳給8051 stub的program memory address內容有誤。直到觀察assembly code才發現某些C code沒有對應的assembly code。
因為我的測試程式寫得太簡單,裡面一些簡單的變數運算可能sdcc判斷為無用。更進一步去觀察測試程式所設定的變數,變數設定太簡單,sdcc會直接定為某個register,而不是給予一個記憶體位子。這樣會間接導致那些變數編譯完後也不存在於symbol table中。
後來變數加入volatile的設定而解決,主要目的是程式對volatile的變數作存取時必須直接到他的位子作讀寫而不是經過暫存器或者cache之類的。這樣的設定也會強制sdcc必須安排volatile的變數一個記憶體位子,而不是定為某個register。
======================10/08=======================
paper投影片
BEE2 是由四個user FPGA和一個control FPGA組成,根據FPGA提供的功能如I/O pins和其要求如供電壓等作設計,最後加上其他周邊硬體如usb, rs232等完成整個平台。
平台裡每個FPGA都加入PowerPC的架構並在control FPGA執行Linux,主要用於控制周邊硬體,監控等。
======================10/06=======================
常常會忘記自己做的東西是很底層的,很多是事情其實直接用inline asm解決即可;也有很多問題是必須trace assembly code才會知道錯誤在哪。
上禮拜是驗證8051 stub回傳的PC是否正確,這禮拜是驗證其他registers(r0-r7 sp)。
驗證方法很簡單,在進入function handle_exception()之前用inline asm隨意指定r0-r7的數值,之後觀察8051 stub回傳的r0-r7和之前指定的數值是否一致。
接下來是之前提到的,回傳的memory數值不正確。
原因是為了8051 stub回傳registers方便,我宣告一些全域變數用來儲存registers的參數;並為了inline asm撰寫方便,宣告時也指定那些全域變數的位子。我本來以為compiler會處理其他(如區域變數)的位子並避開前面我指定位子的全域變數,結果並不會。簡單的判斷方法就是宣告幾個同位子的變數看compiler是否有warning或error。我之所以認為compiler會處理這問題是因為Keil C51就會在變數位子的宣告有重疊時會產生warning,但是我目前用的SDCC卻不會。這問題就會影響到8051 stub回傳memory數值的錯誤,我用以下範例說明。
reg_PC一變數是我宣告用來儲存中斷點的位子,也就是handle_exception function return的位子。所以一開始8051 stub與GDB連線時,stub會進入handle_exception function並回傳所有registers的數值,其中包含PC值,所以在這一點我是直接回傳reg_PC的數值,也是上禮拜用來確定回傳的PC值是否正確的依據。
但是reg_PC也是一個變數可以在symbol table找到,所以可以用指令display reg_PC調出他的數值。用display指令和之前回傳register的方式不太一樣,前者是回傳目標記憶體位子的數值;後者則是直接回傳指定變數的數值。之前會回傳錯誤資訊的原因是因為handle_exception function的區域變數會覆蓋到reg_PC的位子。解決方式就是不要指定位子,全部給compiler分配就好了。
======================9/29========================
8051 stub方面,有個問題是不知道怎麼在C程式裡得到processor暫存器(pc,sp,r0-r7)的資料,後來直接寫inline assembly code來解決。首先宣告一個固定位值的變數如: data unsigned char at 0x20 reg_temp[8],表示變數reg_temp陣列在iram裡的0x20-0x27位子,接著用inline asm 如: mov 0x20, r0 的方式把r0-r7的資料存到reg_temp陣列裡,最後reg_temp就保存了r0-r7的資料了。pc也是用類似的方法,只是inline asm 是用pop push得到進入handle_exception function前的pc值。(handle_exception是stub裡的function,主要是收送GDB端讀寫的封包,一般在程式走到breakpoint會進入的function)
目前我只能驗證stub回傳的pc值是正確的,假設handle_exception function的進入點是在main function裡,可以從symbol table得知main function的起始位子,簡單的計算就可得知stub回傳的pc是否正確了。
接下來的問題是回傳的memory數值不正確,不過應該只是stub哪裡寫錯了,詳細情形我還在找原因。
GDB方面,之前有提到說把register的數值列印出來的指令會導致GDB當掉,原因是出在我GDB裡的TARGET-tdep.c裡對於每個register的宣告上(function enum gdb_regnum)我設定9個register,然而在(function TARGET_analyze_control_transfer)裡分析register裡,也就是switch case裡我少設定一個register,導致找不到那缺少的register case而在default case裡回傳error message的動作。改完後就可以正常的列印出暫存器數值了。
======================8/30========================
debugging stub透過COM port與GDB溝通的方式為RSP(Remote Serial Protocol),其封包格式很簡單: $ddd...#hh。 '$' 是封包的開頭,'ddd...'是十六進位資料且並無限定長度,'#'表示結尾,'hh'為十六進位的兩個checksum。
GDB遠端連線建立好後,會先送出"qSupport",stub收到後回傳"T05"表示停下來的原因是breakpoint,接著stub回傳所有register的資料。以上資訊傳輸完後,GDB就會列印出目前的位值和等待使用者的指令,stub也是在一個無線迴圈內等待GDB的封包。
我目前的遇到的問題是,連線建立後,輸入指令如列印出某暫存器的數值後GDB會死當,根據找的文件是說這可能是BFD那邊的問題,也就是symbol table的問題,真正問題的原因我還在尋找。
至於上個禮拜關於debugging stub回傳暫存器的數值有誤的問題,本來以為燒錄器的問題: 因為同一個程式燒入兩次卻有不同的結果。但是後來請aaa幫忙修理才知道燒錄器沒問題,是晶片at89c51燒壞了。
======================8/24========================
GDB for 8051我想粗分成以下幾個階段:
1. GDB透過COM port能與8051硬體相連,傳輸最基本的功能就是讀寫registers和memory。
2. GDB端的symbol table
3. 支援breakpoint
我目前還在第一階段,想說先架起最基本功能的debugger,可以根據兩端傳輸的資料看出我哪一端有修改錯誤。GDB端要做修改的地方應該比較簡單,主要是修改TARGET-tdep.c和TARGET-dis.c對暫存器的宣告(TARGET=8051)讓GDB認得TARGET的架構;8051硬體端,也就是debugging stub,負責與GDB做溝通,目前最基本的功能就是讀寫暫存器和記憶體。
測試程式方面我是用SDCC (small device c compiler)編譯,產生binary執行檔格式為Intel Hex format。GDB認得這格式為executable file,但是卻會顯示找不到symbol table,因為裡面純粹是程式的資料。不過少了symbol table,GDB應該還是可以讀寫暫存器和記憶體。
目前是卡在debugging stub回傳暫存器的數值有誤,我還在尋找出錯的原因。
第二階段是關於GDB需要的symbol table方面。SDCC編譯C程式可以產生8051的執行檔(Intel Hex Format)和symbol table(CDB format),主要是用於SDCC提供的8051模擬器SDCDB。麻煩的是GDB不支援CDB格式的symbol table,我目前也找不到工具可以將CDB轉成GDB已知的格式如ELF或者COFF等。
GDB認得symbol table的格式定義在BFD,修改BFD讓GDB可以看的懂CDB格式的symbol table,
這應該會是我第二階段要做的。
最後支援breakpoint階段我想等前面的問題釐清後再討論。
======================8/11========================
這是我在meeting時報的paper: Functional Simulation Using Sim-nML
由於時間比較緊迫,我並沒有仔細讀完全部的,上台報告的像是Sim-nML教學。
paper大略的內容是利用Sim-nML語法模擬出一個processor model,作者的Functional Simulator Generator可以parse此model成一個c++的class,並產生一個屬於此processor的simulator。
這simulator可以執行模擬的processor的執行檔,且利用GDB作為介面,remote control這個simulator。
投影片
論文
在meeting的時候提出的討論:
1. (pg. 6) SystemC is targeted more toward system level modeling rather than processor modeling.
對這句話有疑問,systemC不一定就是要用system level來描寫。
2. (pg. 25)—Methods for handling traps and other synchronized events
是指關於interrupt時processor處理的行為,白算盤裡有詳細的解釋。
3. 關於Sim-nML,是有compiler等工具支援,發展至少有十年歷史。
2009年10月20日 星期二

2009年10月15日 星期四
MPEG-4 code SIMD 化 -- 雙魚
=========== 2009.10.15===========
還是拿原本的code來改 , 主要把第一次改的換種方法
以及 找了第二個可以改成SIMD的部分
(1) 第一部分的別種方法:
->本來的方法是圖的上半部 , vector先裝入IDCT_Coeffo [0~3]的數值
讓IDCT_Coeffo 和 V0 相乘結果先暫存在 temp
再把暫存在 temp中的四個數值相加後放進去R0[i]
R0[i] = temp[0] + temp[1] + temp[2] + temp[3] ;
老師有提過 這邊一堆+ 可能會影響速度 , 所以換種方法

-> 後來的方法是圖的下半部 , 先把 IDCT_Coeffo 陣列轉置
轉置的結果IDCT_Coeffo 陣列順序變成 0 4 8 12 ......
讓vector先裝入IDCT_Coeffo [0 4 8 12] 的數值 再和V0相乘
相乘的結果就可以直接放入R0[0~3] 中
下次vector則裝入IDCT_Coeffo [1 5 9 13] 的數值 再和V0相乘
相乘的結果直接和上一次的R0[0~3] 累加 , 使用vec_madd()去累加
(2) 第二部分的改寫 原始code如下 :
for(i = 0; i <= 7; i++) { k = i& 3 ; if(i & 4) { k ^= 3; temp0 = R0[k] - R1[k]; .... } else { temp0 = R0[k] + R1[k]; ... } .....(略) } -> 觀察一下原本的內容 , 發現迴圈跑8次要做的事情就是產生
R0[0] + R1[0] ,R0[1] + R1[1] ,R0[2] + R1[2] ,R0[3] + R1[3] ,
R0[3] - R1[3] ,R0[2] - R1[2] ,R0[1] - R1[1] ,R0[0] - R1[0]

-> R0 R1在迴圈之前已經計算好 , 迴圈裡面只要他們之間相加減的數值
於是想說新開一個長度8的一維陣列 , 直接把相加減的數值給放好
如此一來 迴圈裡面的這個部份就可以抽掉
R0[k]+R1[k] / R0[k]-R0[k] 可用SIMD提供的 add / sub函式來完成計算
R0[k]-R0[k] 放入btmp[8]的順序如圖 , 從k=3放回來
計算時的vector是從k=0~3裝入 , 相減的結果要先交換位置才能放入btmp
(3) 數據結果 程式跑10000次 :
1. 原始程式在PPE環境下: 1.48 sec
改寫的程式在PPE環境下: 1.15 sec
2. 原始程式在SPE環境下: 1.28 sec
改寫的程式在SPE環境下: 0.48 sec
-> PPE和SPE都是一樣的程式 , 只是使用的函式不同
因為兩個環境支援的函式名稱是不一樣的 , 但是數據差距有點大
PPE只比原本的少了0.3 , 但SPE少了快三倍
我有請小新學長看一下程式 , 應該沒漏掉或放錯迴圈次數
我們兩個對於PPE為什麼只少0.3 都感到很奇怪
=========== 2009.10.8 ===========
整理了在PPE和SPE下寫的兩個範例
一個是4*4矩陣 , 另一個陣列比大小
範例的寫法也有附上解釋
會和大鈞學長討論哪裡還需要做修改
=========== 2009.09.24 ===========
SIMD程式分為使用VMX指令的PPE和使用SPU SIMD指令的SPE
當初會想用PPE是因為不知道怎樣把SPE裡面的時間傳出來
後來可以把測的時間傳出來 , 於是可以去測SPE提供的指令時間
下午報告的數據 因為迴圈次數給錯 , 導致vec_madd()的時間會較慢
所以我把數據重測了一次 , 結果如下:
(1) 一維陣列相乘

(2) 4*4矩陣相乘

從(1)(2)數據看來 , PPE的vec_madd()函式會比原本節省大約3倍
SPE的spu_mul()函式會比原本節省大約4倍
因為兩種函式都有大幅度的降低時間 , 但是改寫的code效果沒有很好
可能要更改原本程式 , 讓原本的程式能比較適合用在SIMD上
=========== 2009.09.16 ===========
把改寫成SIMD的部分下去測時間 , 時間比較如下:

會發現改寫成SIMD的程式時間 比原本的程式還慢
主要改寫後的程式如下:
原本 : R0[i] += IDCT_Coeff0[k+0] * V0[i];
SIMD : tmp[q] = vec_madd( id_c0[i] , v0[q] , vzero );
R0[i] = Tmp[i] + Tmp[i+1] + Tmp[i+2] + Tmp[i+3] ;
-> 做法是 , 一次讓IDCT_Coeff0[k+0] * V0[i] 的計算做完
把數值存在tmp陣列裡面 , 接著把陣列數值相加再給R0
老師提到 , 把數值給R0[i]用到很多個+ , 可能是這邊導致速度變慢
因為之前沒有實際測過 SIMD支援的函式 是否真的有加速功能
這個禮拜會寫簡單的例子去測時間 .
小新學長說先寫簡單的一維陣列相乘 , 確定SIMD的函式是否有加快
如果有加快 , 再寫矩陣相乘的範例 , 然後去測時間
=========== 2009.08.31 ===========
原本cpp檔需要傳入的參數有7個 , 參照小新學長的意見
除了Mode不是等於0 就是 1 , 其他6個都當成64的一維陣列
這7個參數直接在cpp檔設定 , 一維陣列的數值先隨意給 , 設定如下:
int Mode=0 ;
int BlockLT[64] __attribute__((aligned(16)));
int BlockRT[64] __attribute__((aligned(16)));
int BlockLB[64] __attribute__((aligned(16)));
int BlockRB[64] __attribute__((aligned(16)));
int BlockU[64] __attribute__((aligned(16)));
int BlockV[64] __attribute__((aligned(16)));
在compile時遇到幾個問題或錯誤:
(1) compile時指令的改變
之前寫的範例都是 .c檔 , 這次則是 .cpp檔
所以把指令中的 " gcc " 換成 " g++ " , 這樣就可以了
(2) spu_mul()的語法錯誤
一開始是寫 tmp = spu_mul( id_c0[k], v0) ;
tmp 和 v0這兩個vector所乘載的陣列大小只有4
剛好vector一次就是裝四個 , 以為這樣可以 , 但是compile會有錯誤
後來改成 tmp[q] = spu_mul( id_c0[k] , v0[q] ) ; 變數 q=0
雖然 tmp 和 v0大小只有4 , 但還是要告知vector的起始點
另外 要使用spu_mul() , vector宣告的型態要為float
原本程式V0型態為 int
所以寫成 __vector int *v0 = (__vector int *) V0 ;
compile時會顯示錯誤 , 上網找資料看到都是用float
改成 __vector float *v0 = (__vector float *) V0 ;
這樣執行起來就不會出現錯誤了
測試方面使用SPU SIMD指令的方式
寫了PPE+SPE , SPE裡面就放cpp檔內容
打入compile需要的指令 , 目前不會出現錯誤
但是SPE裡面不能用printf , 這樣無法看到算出來的數字對不對
想說把要印的數值傳到PPE裡 , 執行後印出的數字都是0
可能是要印出的數值沒有傳好 , 或者是數值上有算錯
這邊會想辦法去解決
=========== 2009.08.24 ===========
參考aaa學長提出的兩個方法 , 覺得第二種方法比較簡單
利用這種方法 , 程式碼中原本 d0~d11的變數就可以拿掉
但是第二種方法的問題出在下圖這段程式碼
R0[i] += IDCT_Coeff0[k+0] * V0[0];
R0[i] += IDCT_Coeff0[k+1] * V0[1];
R0[i] += IDCT_Coeff0[k+2] * V0[2];
R0[i] += IDCT_Coeff0[k+3] * V0[3];

--> 這等於把 IDCT_Coeff0陣列和V0陣列相乘的數值都放在R0[i]
SIMD語法中好像沒有這種計算的函式 , 所以不能直接這樣寫
所以把程式碼改寫 如下:
Tmp[i] = IDCT_Coeff0[k+0] * V0[0];
Tmp[i+1] = IDCT_Coeff0[k+1] * V0[1];
Tmp[i+2] = IDCT_Coeff0[k+2] * V0[2];
Tmp[i+3] = IDCT_Coeff0[k+3] * V0[3];
R0[i] = Tmp[i] + Tmp[i+1] + Tmp[i+2] + Tmp[i+3] ;

--> 新開一個tmp[4]陣列,用來暫存 IDCT_Coeff0和V0相乘的數值
把 tmp陣列中四個數值相加後 , 再放回R0[i]
這樣一來 IDCT_Coeff0陣列和V0陣列相乘 的部分就可以一次作
測試的方法: 幫 原本的cpp 和 SIMD化的cpp 各寫PPE+SPE
然後給入一樣的參數數值 , 再去看兩者時間的差別有多少
目前在寫這兩個的PPE+SPE , 但傳入的參數還弄不清楚
所以還無法把程式跑起來
=========== 2009.08.12 ===========
從bbb學長給的mpeg-4檔案中 , 找出要做SIMD的檔案
主要就是改 MacroBlock_DCT_IDCT.cpp
下圖是目前要改成SIMD的地方

(1) 上圖第一個框框的部分, 希望可以用vector去裝變數d0~d11
這樣一次就可以assign 四個變數
(2) 同一個迴圈內, A0=B0+C0 , A1=B1+C1, ..... 這種計算可以改寫
但是 A0=B0+C0 , A1=D1+C1 , A2=B0+C3 ,... 這種不行
所以我把第二個框框的迴圈內容想成下面這樣

希望藉著此種想法 , 讓迴圈內的程式可以改成SIMD化
還是拿原本的code來改 , 主要把第一次改的換種方法
以及 找了第二個可以改成SIMD的部分
(1) 第一部分的別種方法:
->本來的方法是圖的上半部 , vector先裝入IDCT_Coeffo [0~3]的數值
讓IDCT_Coeffo 和 V0 相乘結果先暫存在 temp
再把暫存在 temp中的四個數值相加後放進去R0[i]
R0[i] = temp[0] + temp[1] + temp[2] + temp[3] ;
老師有提過 這邊一堆+ 可能會影響速度 , 所以換種方法

-> 後來的方法是圖的下半部 , 先把 IDCT_Coeffo 陣列轉置
轉置的結果IDCT_Coeffo 陣列順序變成 0 4 8 12 ......
讓vector先裝入IDCT_Coeffo [0 4 8 12] 的數值 再和V0相乘
相乘的結果就可以直接放入R0[0~3] 中
下次vector則裝入IDCT_Coeffo [1 5 9 13] 的數值 再和V0相乘
相乘的結果直接和上一次的R0[0~3] 累加 , 使用vec_madd()去累加
(2) 第二部分的改寫 原始code如下 :
for(i = 0; i <= 7; i++) { k = i& 3 ; if(i & 4) { k ^= 3; temp0 = R0[k] - R1[k]; .... } else { temp0 = R0[k] + R1[k]; ... } .....(略) } -> 觀察一下原本的內容 , 發現迴圈跑8次要做的事情就是產生
R0[0] + R1[0] ,R0[1] + R1[1] ,R0[2] + R1[2] ,R0[3] + R1[3] ,
R0[3] - R1[3] ,R0[2] - R1[2] ,R0[1] - R1[1] ,R0[0] - R1[0]

-> R0 R1在迴圈之前已經計算好 , 迴圈裡面只要他們之間相加減的數值
於是想說新開一個長度8的一維陣列 , 直接把相加減的數值給放好
如此一來 迴圈裡面的這個部份就可以抽掉
R0[k]+R1[k] / R0[k]-R0[k] 可用SIMD提供的 add / sub函式來完成計算
R0[k]-R0[k] 放入btmp[8]的順序如圖 , 從k=3放回來
計算時的vector是從k=0~3裝入 , 相減的結果要先交換位置才能放入btmp
(3) 數據結果 程式跑10000次 :
1. 原始程式在PPE環境下: 1.48 sec
改寫的程式在PPE環境下: 1.15 sec
2. 原始程式在SPE環境下: 1.28 sec
改寫的程式在SPE環境下: 0.48 sec
-> PPE和SPE都是一樣的程式 , 只是使用的函式不同
因為兩個環境支援的函式名稱是不一樣的 , 但是數據差距有點大
PPE只比原本的少了0.3 , 但SPE少了快三倍
我有請小新學長看一下程式 , 應該沒漏掉或放錯迴圈次數
我們兩個對於PPE為什麼只少0.3 都感到很奇怪
=========== 2009.10.8 ===========
整理了在PPE和SPE下寫的兩個範例
一個是4*4矩陣 , 另一個陣列比大小
範例的寫法也有附上解釋
會和大鈞學長討論哪裡還需要做修改
=========== 2009.09.24 ===========
SIMD程式分為使用VMX指令的PPE和使用SPU SIMD指令的SPE
當初會想用PPE是因為不知道怎樣把SPE裡面的時間傳出來
後來可以把測的時間傳出來 , 於是可以去測SPE提供的指令時間
下午報告的數據 因為迴圈次數給錯 , 導致vec_madd()的時間會較慢
所以我把數據重測了一次 , 結果如下:
(1) 一維陣列相乘

(2) 4*4矩陣相乘

從(1)(2)數據看來 , PPE的vec_madd()函式會比原本節省大約3倍
SPE的spu_mul()函式會比原本節省大約4倍
因為兩種函式都有大幅度的降低時間 , 但是改寫的code效果沒有很好
可能要更改原本程式 , 讓原本的程式能比較適合用在SIMD上
=========== 2009.09.16 ===========
把改寫成SIMD的部分下去測時間 , 時間比較如下:

會發現改寫成SIMD的程式時間 比原本的程式還慢
主要改寫後的程式如下:
原本 : R0[i] += IDCT_Coeff0[k+0] * V0[i];
SIMD : tmp[q] = vec_madd( id_c0[i] , v0[q] , vzero );
R0[i] = Tmp[i] + Tmp[i+1] + Tmp[i+2] + Tmp[i+3] ;
-> 做法是 , 一次讓IDCT_Coeff0[k+0] * V0[i] 的計算做完
把數值存在tmp陣列裡面 , 接著把陣列數值相加再給R0
老師提到 , 把數值給R0[i]用到很多個+ , 可能是這邊導致速度變慢
因為之前沒有實際測過 SIMD支援的函式 是否真的有加速功能
這個禮拜會寫簡單的例子去測時間 .
小新學長說先寫簡單的一維陣列相乘 , 確定SIMD的函式是否有加快
如果有加快 , 再寫矩陣相乘的範例 , 然後去測時間
=========== 2009.08.31 ===========
原本cpp檔需要傳入的參數有7個 , 參照小新學長的意見
除了Mode不是等於0 就是 1 , 其他6個都當成64的一維陣列
這7個參數直接在cpp檔設定 , 一維陣列的數值先隨意給 , 設定如下:
int Mode=0 ;
int BlockLT[64] __attribute__((aligned(16)));
int BlockRT[64] __attribute__((aligned(16)));
int BlockLB[64] __attribute__((aligned(16)));
int BlockRB[64] __attribute__((aligned(16)));
int BlockU[64] __attribute__((aligned(16)));
int BlockV[64] __attribute__((aligned(16)));
在compile時遇到幾個問題或錯誤:
(1) compile時指令的改變
之前寫的範例都是 .c檔 , 這次則是 .cpp檔
所以把指令中的 " gcc " 換成 " g++ " , 這樣就可以了
(2) spu_mul()的語法錯誤
一開始是寫 tmp = spu_mul( id_c0[k], v0) ;
tmp 和 v0這兩個vector所乘載的陣列大小只有4
剛好vector一次就是裝四個 , 以為這樣可以 , 但是compile會有錯誤
後來改成 tmp[q] = spu_mul( id_c0[k] , v0[q] ) ; 變數 q=0
雖然 tmp 和 v0大小只有4 , 但還是要告知vector的起始點
另外 要使用spu_mul() , vector宣告的型態要為float
原本程式V0型態為 int
所以寫成 __vector int *v0 = (__vector int *) V0 ;
compile時會顯示錯誤 , 上網找資料看到都是用float
改成 __vector float *v0 = (__vector float *) V0 ;
這樣執行起來就不會出現錯誤了
測試方面使用SPU SIMD指令的方式
寫了PPE+SPE , SPE裡面就放cpp檔內容
打入compile需要的指令 , 目前不會出現錯誤
但是SPE裡面不能用printf , 這樣無法看到算出來的數字對不對
想說把要印的數值傳到PPE裡 , 執行後印出的數字都是0
可能是要印出的數值沒有傳好 , 或者是數值上有算錯
這邊會想辦法去解決
=========== 2009.08.24 ===========
參考aaa學長提出的兩個方法 , 覺得第二種方法比較簡單
利用這種方法 , 程式碼中原本 d0~d11的變數就可以拿掉
但是第二種方法的問題出在下圖這段程式碼
R0[i] += IDCT_Coeff0[k+0] * V0[0];
R0[i] += IDCT_Coeff0[k+1] * V0[1];
R0[i] += IDCT_Coeff0[k+2] * V0[2];
R0[i] += IDCT_Coeff0[k+3] * V0[3];

--> 這等於把 IDCT_Coeff0陣列和V0陣列相乘的數值都放在R0[i]
SIMD語法中好像沒有這種計算的函式 , 所以不能直接這樣寫
所以把程式碼改寫 如下:
Tmp[i] = IDCT_Coeff0[k+0] * V0[0];
Tmp[i+1] = IDCT_Coeff0[k+1] * V0[1];
Tmp[i+2] = IDCT_Coeff0[k+2] * V0[2];
Tmp[i+3] = IDCT_Coeff0[k+3] * V0[3];
R0[i] = Tmp[i] + Tmp[i+1] + Tmp[i+2] + Tmp[i+3] ;

--> 新開一個tmp[4]陣列,用來暫存 IDCT_Coeff0和V0相乘的數值
把 tmp陣列中四個數值相加後 , 再放回R0[i]
這樣一來 IDCT_Coeff0陣列和V0陣列相乘 的部分就可以一次作
測試的方法: 幫 原本的cpp 和 SIMD化的cpp 各寫PPE+SPE
然後給入一樣的參數數值 , 再去看兩者時間的差別有多少
目前在寫這兩個的PPE+SPE , 但傳入的參數還弄不清楚
所以還無法把程式跑起來
=========== 2009.08.12 ===========
從bbb學長給的mpeg-4檔案中 , 找出要做SIMD的檔案
主要就是改 MacroBlock_DCT_IDCT.cpp
下圖是目前要改成SIMD的地方

(1) 上圖第一個框框的部分, 希望可以用vector去裝變數d0~d11
這樣一次就可以assign 四個變數
(2) 同一個迴圈內, A0=B0+C0 , A1=B1+C1, ..... 這種計算可以改寫
但是 A0=B0+C0 , A1=D1+C1 , A2=B0+C3 ,... 這種不行
所以我把第二個框框的迴圈內容想成下面這樣

希望藉著此種想法 , 讓迴圈內的程式可以改成SIMD化
2009年10月12日 星期一
Special Topic on ESL and Multi-core Tool Design
Syllabus
1. SystemC Simulation Kernel
2. Advanced OpenESL tool development
3. TLM2.X
4. ARM Processor ESL Model
5. Multi-core Virtual Model
6. Multi-core Programming on Virtual Model
7. Multi-core application programming using CUDA
8. Debugging tool for microprocessors
09/23 - 10/07
1. SystemC Simulation Kernel
2. Advanced OpenESL tool development
3. TLM2.X
4. ARM Processor ESL Model
5. Multi-core Virtual Model
6. Multi-core Programming on Virtual Model
7. Multi-core application programming using CUDA
8. Debugging tool for microprocessors
09/23 - 10/07
2009年10月3日 星期六
C++ 中 struct 與 class keywords 的差異
C++ 中允許使用者在宣告(declare)、定義(define)型別時,使用 struct, class 兩個不同的關鍵字(keyword)。由於兩種都可以,因此很容易讓人好奇兩者是否存在必要性的差異。
在宣告時,使用 struct 或 class 都可以告訴 compiler 這是一個新的自訂型別,但在定義(define)時則有差異,根據最新 C++ standard
的描述, class 和 struct 對於 class definition 的差別在於:
1. 對於 member 的 default access level 不同(std.11);
2. 對於 base class 的default access level 不同(std.11.2)。
其不同在於 struct 是寬鬆的,都以 public 為預設。
上面的敘述很簡單,會引發一些聯想、甚至遐想:
Q1: 所以也可以使用 struct 寫多重繼承?多形?實現建構/解構子概念? 或者實作interface?就算可以,那為何會有class的產生?它不正是為了延伸structure的概念,達到更方便的OOP設計嗎?class 跟 struct 是可以互相繼承的嗎?
A1: 是的,可以。
Q2: 如果 Q1 的程式存成 .c ,可以compile過嗎?
A2: 沒辦法,C 語言不支援
Q3: 剛提到的差異是 class definition 上的,至於其他地方有差異嗎?
A3: 有的,像是 template 的 parameter list 只允許 class, typename ,無法使用 struct,因為 template 的設計,一開始就沒有打算和 C 相容。
Q4: 扣除些微差異,class 和 struct 幾乎是一樣的東西,為什麼 C++ 會同時引入兩個 keywords 呢?
A3: C++ 原本叫做: C with Class 。它的重要理念之一是與 C 相容,不過確實也是有不相容的地方,C++ Standard 的附錄 C 就列舉了 C++ 與 C 不相容的部份。因此為了這相容性,不可能將 struct keyword 拿掉,引入 class 這個新的 keyword ,它所帶來的不只是 parser 要多 parse 一個字,更重要的是其背後的抽象性、封裝性以及滿足人們對於 OO 的期待心理。而且以 Google 上"C++ struct class?"的搜尋,會先冒出一堆兩者的差異、比較的網頁就知道,class 的確辦到了"混淆視聽"的效果 : )
Q5: 都聽你在講,有沒有權威一點的說法啊?
A5: Stanley Lippman 的著作: Inside The C++ Object Model,裡頭有一個章節叫做:Keywords, Schmeewords;開頭就是這樣說的:
One answer to the question of when, if ever, you should use a struct declaration rather than a class declaration then, is whenever it makes one feel better.
是的,重點在於 struct, class 定義出的 attributes, member functions 是否能符合你的需求期望。兩者的差異在於主觀的感覺: struct 用在 data aggregation,class 用在 Object oriented 或 object based 上。
Q6: 那為什麼不在 C++ 內限制 struct 只能宣告一般 aggregation type,不能有 access level 、member function 等能力呢?
A6: 其實原因很簡單:只是為了 C 到 C++ 遷移順利。 C++ 草創之初,除了效能是個大家關注的議題之外,什麼時候使用 struct 取代 class 也是常被問起的問題,與其涇渭分明的兩套標準,不如以一貫之,Bjarnet Stroustup 在 The Design and Evolution of C++ 這樣講著:
Maybe we could have lived with two set of rules, but a single concept provides a smoother integration of features and simpler implementation.尤其重要的是,嚴格區分兩者可能使得社群分裂(原文: community would fall into two distinct camps that would soon stop communicating.)
ㄜ,除了上面講的顏色對不對外,你覺得下面的 code 該編譯過還是不過呢?
// Forward Declaration
struct MyClass;
// Definition
class MyClass {
...
};
這應該是一致性問題,還是我們得一定要 compiler 嚴守 langauage 規範,幫我們挑出來呢? (以上很哲學又考古! )
Q7: 那我可以說 struct 原本要被幹掉嗎?
A7: 不算是要被幹掉,因為一開始就打算與 C 相容,所以不會幹掉,考量是:
1. 要不要引入新的 keywrod -- class
2. 引入 class 後,是否要讓 struct 與 class 不相容,使用兩套 rules。
而後的決定是:引入 class ,class 和 struct 使用同一套 rules (只差別在 default accessibility),而事實也證明 class 帶來令人滿意的效果,不管是心理的、實務上的。心理的上的話,套句 Lippman 的話:你會講 base class 還是 base struct ,雖然只是小小的哲學問題,卻還是得到滿足。
Q8: 我搞混了,那到底什麼時候該用 struct 、什麼時候該用 class?
A8: 我想 C++ 期望使用者自決。但我想可以分成兩個層面來看。先說心理層面:這是個 makes one feel better 的問題。
xxx MyClass {
public:
void func();
private:
int val_;
};
xxx 是 class or struct 都好,因為實際描述 MyClass 行為的是 class body 中的程式碼,而不是 struct 或 class。
另一個層面則比較實務:我想要 struct 或 class 定義出來的型別,其所產生的 object 與 C 是真正相容的,那就得考慮到 C++ 的 object model 和相關運算,簡單來說:要在 C++ 產生跟 C 相容的 object ,你的 C++ 型別必須是個 POD (Plain Old Data),standard 對於 POD 有其定義(std.9),或是上 Google 搜尋都可以看到,偷偷引用 wiki 的描述:
A POD type is a C++ type that has an equivalent in C, and that uses the same rules as C uses for
1. initialization
2. copying
3. layout
4. addressing
對我自己來說,什麼時候會使用 struct:
1. 想產生與 C 相容的 object 時,我會使用 struct 這個關鍵字,因為它帶有我對 C 的遐想,然後嚴格遵守 standard 對 POD 的規範。
2. 某些型別描述的對象很簡單(不太有(甚至沒有)繼承架構、抽象介面、生命週期短等),使用 setter, getter 又很麻煩時,那我會選使用 struct ,像是:
struct ParserResult {
bool Match;
int lineNo;
};
每個人都可以有自己一套結論!
Q8: 我試過了你這篇文章上弔詭(Paradox)的code:
struct MyClass;
class MyClass {};
/*
*warning C4099: 'MyClass' : type name first seen using 'struct' now seen using 'class'
*
*是的,可以通過編譯,但會出現如此警告。
*因此將class、struct調換過來如下:
*/
class MyClass {};
struct MyClass;
/*
*錯誤訊息如下:
*warning C4099: 'MyClass' : type name first seen using 'class' now seen using 'struct'
*/
A8: 揪甘心,這就是答案。記住:你的血統(class, struct)不代表什麼,重要的是你的所作所為(class body)
2009年9月18日 星期五
2009年9月17日 星期四
Cyber Simulation - 宗胤
--- [09.09.16] ------------------------------------------------
目前完成的部份是可以將一個簡單的加減法電路掛到CDK板子的FPGA上,並且可透過ICE Server讓Host (PC)存取這個加減法電路,也可讓CDK上的Linux透過Driver使一隻User Space的程式可以存取這個電路。
CDK上的FPGA是透過AHB或APB與其他的硬體作溝通,因此要在FPGA上實作電路必須要實做與AHB或APB溝通的interface,這個interface我是直接使用CDK所給的範例裡的,我只修改最底層的電路。
另外,照CDK的規格書所述,基本上我們可以在fpga上實作兩個Slave掛在AHB下,而Bus上的Memory Map是已經給定好的:
- Slave1是Map在0x1CB20000,大小為2MB
- Slave2是Map在0x1CD20000,大小為2MB
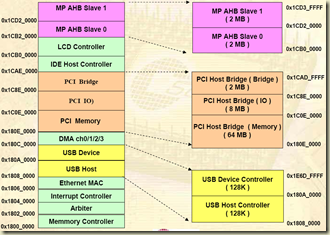
因此我透過範例的interface將電路實作在Slave1裡,讓其他硬體可透過0x1CB20000這個位址與其作溝通。

上面是利用ICE Server讓Host在CDK上跑一隻簡單的程式,其中紅框中的slavebase即是儲存0x1CB20000,然後就透過存取slavebase直接與FPGA的電路溝通。藍框中是執行的結果。

而上圖則是先在CDK上boot Linux後,利用我寫的簡單driver (calculate.ko)來讓armtest這隻程式可以輸入2個數值給電路來做相加和相減。基本上armteset是透過ioctl這個function來與硬體做溝通,程式碼如下,將Device打開就利用driver事先定義好的command發命令至driver,driver再根據command控制加減法電路。

再來應該是要做關於driver codegen的部份,但要寫codegen的話勢必要有一定程度至瞭解Linux driver,所以我想我應該要找個driver trace。
2009年9月15日 星期二
有關Group Meeting
2009, 9/15
DNA : 新的時間表 嘎喔
DNA : 新的時間表 嘎喔
時間: 星期四下午2:00
地點: 未定 (暫定4282)
報告順序:
日期 | 報告成員 |
9/24 | 阿凡、小聽 |
10/1 | 皓鈞(補)、宗胤(補) |
10/8 | 仕偉、品皓、大鈞 |
10/15 | 胤霖、宗胤、小明 |
10/22 | 嚕嚕、塞公、偉翔 |
10/29 | 小龍、雙魚、皓鈞 |
11/5 | 阿凡、小聽 |
11/12 | 仕偉、品皓、大鈞 |
11/19 | 胤霖、宗胤、小明 |
11/26 | 嚕嚕、塞公、偉翔 |
12/3 | 小龍、雙魚、皓鈞 |
12/10 | 阿凡、小聽 |
| |
12/24 | 仕偉、品皓、大鈞 |
12/31 | 胤霖、宗胤、小明 |
1/7 | 嚕嚕、塞公、偉翔 |
1/14 | 小龍、雙魚、皓鈞 |
1/21 | 阿凡、小聽 |
1/28 | 仕偉、品皓、大鈞 |
2/4 | 胤霖、宗胤、小明 |
2/11 | 嚕嚕、塞公、偉翔 |
------------------------------------------------------------------
2009, 9/15
新的Group Meeting時間為每星期四下午兩點.
請DNA重新排報告的同學的時間表
------------------------------------------------------------------
2009,9/9
開學後的Group meeting請重新調查時間. 我的上課時間是:
(三)6~8. RM4261. 研究所的Multicore的課.
(四)2~4. RM4263. 大學部的System Level Programming
請大家上來說一下自己的上課時段, 請DNA排出時間並借教室.
至於Meeting的內容還是以報Paper為主, 每次三位同學比較好, 否則兩個月才會輪一次, 有點久.
Meeting的另一個目的本來是報告進度, 不過我覺得大家也許感到還沒做到一個地步就報告會不知道報什麼. 所以就改成你做到可以初步展示時再上來就好. 但是我又不希望隔太久, 所以強制一下, 一個月來展示一次. 但是我請大家自動自發, 每個禮拜在你的工作串上發表進度. 發表內容希望言之有物, 讓人知道你在做什麼. 也就是要交代前因與結果.
並且, "把串提到上面來, 並註明更新日期"
明年想畢業的同學, 固定兩星期上來展示一下你的成果. 所謂展示, 不是口頭報告, 要有Demo才行.
另外, 等穩定後, 約在十月中, 如我所說我會再找時間, 由我或博士班的學長幫碩一同學上一些課. 並且定一下個別meeting的時間與方式.
-----------------------------------------------------------------
4285被張大偉老師借去,奇怪的是他們每週二都註明是training course,晚點去系辦反應完看看能不能換,我們人數較多要借較大的教室。
時間: 早上10點
地點: 未定
報告順序:
日期 | 報告成員 |
8/11 | 品皓、仕偉 |
8/18 | 胤霖、大鈞 |
8/25 | 小明、宗胤 |
9/1 | 塞公、嚕嚕 |
9/8 | 偉祥、皓鈞 |
9/15 | 小龍、雙魚 |
9/22 | 阿凡、小聽 |
9/29 | |
10/6 | 品皓、仕偉 |
10/13 | 胤霖、大鈞 |
10/20 | 小明、宗胤 |
10/27 | 塞公、嚕嚕 |
11/3 | 偉祥、皓鈞 |
11/10 | 小龍、雙魚 |
11/17 | 阿凡、小聽 |
11/24 |
進度報告: 每兩週一次
其他注意事項:
- 論文不知道要報什麼的請找你的Mentor或找老師。
- 下週三(8/12)早上10點大掃除!
演講:探索嵌入式 ARM 平台與 SoC -- Part I + Part II
演講:探索嵌入式 ARM 平台與 SoC -- Part I + Part I
推薦一下這個演講,講師是鼎港有名聲,下港尚出名ㄟ黃敬群(Jserv)
有在做ESL/ARM相關的人或有興趣的人可以去聽一下
看真實的系統長什麼樣,以軟體的角度是怎樣看待ARM/SoC System
業界又是如何來設計及使用ARM/SoC System
我相信Jserv可以提供許多寶貴的意見
詳細的時間地點,請參照連結內容
閒閒沒事做的,也可以去看一下本系有史以來最強的學長本尊
在現場你一定可以感受到他的無邊法力 XD
推薦一下這個演講,講師是鼎港有名聲,下港尚出名ㄟ黃敬群(Jserv)
有在做ESL/ARM相關的人或有興趣的人可以去聽一下
看真實的系統長什麼樣,以軟體的角度是怎樣看待ARM/SoC System
業界又是如何來設計及使用ARM/SoC System
我相信Jserv可以提供許多寶貴的意見
詳細的時間地點,請參照連結內容
閒閒沒事做的,也可以去看一下本系有史以來最強的學長本尊
在現場你一定可以感受到他的無邊法力 XD
2009年9月13日 星期日
Vertical Bit Map Coding
[2009-09-20]
Bad news. I have found one bug in my Matlab code. The bitrate counter have been implemented in a wrong way so that the bitrate have been overcounted. The bitstream of 32kbps is actually the bitstream of 64kbps. Therefore, the coding efficiency shall be further underestimated.
=====================================================
A. Introduction
For recording my research in audio bit plane coding technique, here I demonstrate a series of decoded results produced by a fine-grain-scalable lossy-to-lossless audio coder. The key idea is quite simple but effective. From my doctoral study, I learned the significant map (the most significant bits of all coefficient to be encoded) plays a critical role in both coding efficiency and audio quality. If I can use as less bits as possible to encode the significant map, then the decoded quality will be as good as possible even in a very low bitrate. Unlike the scalable audio coder, Harmonic Quad Tree coding (HQT), in my doctoral thesis, this coder explores the relationship between the most significant bits of two adjacent frequency coefficients, not harmonic relationships among frequency coefficients. In addition, the bit plane coding technique, Set Partitioning In Hierarchical Trees (SPIHT), is absent in the new coder. I would like to named this coder as Vertical Bit Map coding (VBM) at this moment.
B. Experiment
The chosen test audio piece is from "castant" which is a famous test material for audio compression. Due to its rich and fast claps, the audio artifact so called "pre-echo" can be easily perceived after lossy compressed.
The following two examples show an interesting function I called it variable bitrate playback. To make you quickly understand this function, I decoded the bitstreams according a series of specified varying bitrates frame by frame and drawn their spectrum. The figures have the original spectrum in the top, the decoded spectrum in the middle, and the specified varying decoding bitrate of each frame in the bottom.
The first experiment is set the varying bitrate from 16kbps to 64kbps in a step size of 2kbits.

The second experiment is set the varying bitrate from 32kbps to 64kbps in a step unit of 1kbits. The audio qualities are very defective because these two experiments are extraordinary only for demonstration. In an usual scenario, the varying decoding bitrate is expected to change in a smooth way. For keeping acceptable audio quality, the decoding bitrate would not be allowed to adjust so frequently and amplify so large range in a short time.

There are also some comparsions with other scalable audio coders. They can be downloaded from Result Comparsion, all 44.1KHz, 16-bit, mono.
The file list describes briefly here,
cast_ori.wav – castant original wave file
cast_rec_(16_64_2kbps).wav – the first experiment
cast_rec_(32_64_1kbps).wav – the second experiment
cast_rec_(16kbps).wav – 16kbps fixed rate VBM version
cast_rec_(32kbps).wav – 32kbps fixed rate VBM version
cast_rec_(64kbps).wav – 64kbps fixed rate VBM version
cast32_bsac.wav – 32kbps fixed rate MPEG4 BSAC version
cast32_sac.wav – 32kbps fixed rate Scala SAC version
cast32_hqt.wav – 32kbps fixed rate HQT version
cast32_eac.wav – 32kbps fixed rate Mircosoft EAC version
C. Summary
As a conclusion and a reminder for myself, this VBM coder is an experiment of my speculation in the importance of significat map in audio coding. This VBM audio coder can be categorized as:
1. Fine-scalability: scalable grain is downto 1 bit,
2. Lossy-to-lossless: the embedded bitstream contains all possible playback bitrates, even the archive,
3. Low complexity: there are very few prediction calculations and history storages in analyzing and reconstucting the significant map. Therefore it can be claimed that complexity is equivalent and low in both encoding and decoding,
and has the following features:
1. Encode once, decode many time: the basic goal VBM tries to achieve,
2. Variable bitrate playback: by indicating the decoding bitrate of every frame, decoder can achieve variable bitrate playback in frame scale,
3. Real-time encoding and decoding.
It is noted that the VBM coder has NO
1. Psychoaoustic model: there is no perceptual controlling in the current implement,
2. Window switch: there is no attack detection to control long/short window switch. Yes, there is one single frame size.
2009年9月4日 星期五
DAFx @ Italy
I’ve just finished my poster presentation at the vanue. There were so many interesting guys coming with many interesting thoughts. I prepared my business cards and the papers which were proposed by 義崧 and 維城 for the audiences who need.
Because our paper includes the fields such as pitch detection, partials tracking, score alignment, and also synthesis, there are many people coming to ask me some questions. The most popular question is the octave note (or overtone) of the multiple pitch detecion. The tracking algorithm is also the well-liked topic.
I also got the name card from Keita (the supervisor of Center for Advanced Sound Technologies in YAMAHA Corp.) and Juhan Nam (Ph.D candidate in CCRAM). There are also some guys coming from IRCAM and even know 維城.
Finally, Perry Cook is a really interesting guy who may give you a whistle whenever your demostration is impressive !
訂閱:
文章 (Atom)